Apache Iceberg: format tabeli, na którym można oprzeć plan wyjścia
Grupa przejmuje spółkę i dziedziczy jej środowisko danych: grupa prowadzi Trino nad własnym magazynem obiektowym, przejęta spółka pracuje na Snowflake, a obie potrzebują teraz tych samych tabel klientów i zamówień. Zwykła odpowiedź to nocna kopia w każdą stronę i dwa zespoły, które do wiosny przestają ufać swoim liczbom. Mniej zwykła odpowiedź to jeden zestaw tabel, które oba silniki czytają i zapisują — do tego został zaprojektowany Apache Iceberg.
Iceberg jest formatem tabel, co do którego zgodziło się najwięcej vendorów: Snowflake, AWS, Google Cloud, Databricks, Microsoft Fabric przez OneLake i silniki otwarte — Spark, Flink, Trino, DuckDB. Zgoda wynika z architektury, nie z dobrej woli, i w tej architekturze siedzi też pozostała zależność. W poradniku o dwóch pamięciach systemu AI-native lakehouse jest pamięcią, która przeżywa każdy pojedynczy silnik; Iceberg to format, który traktuje tę obietnicę najdosłowniej, pod warunkiem że katalog potraktuje się jak decyzję, którą jest.
Drzewo i jedyna rzecz, która się rusza
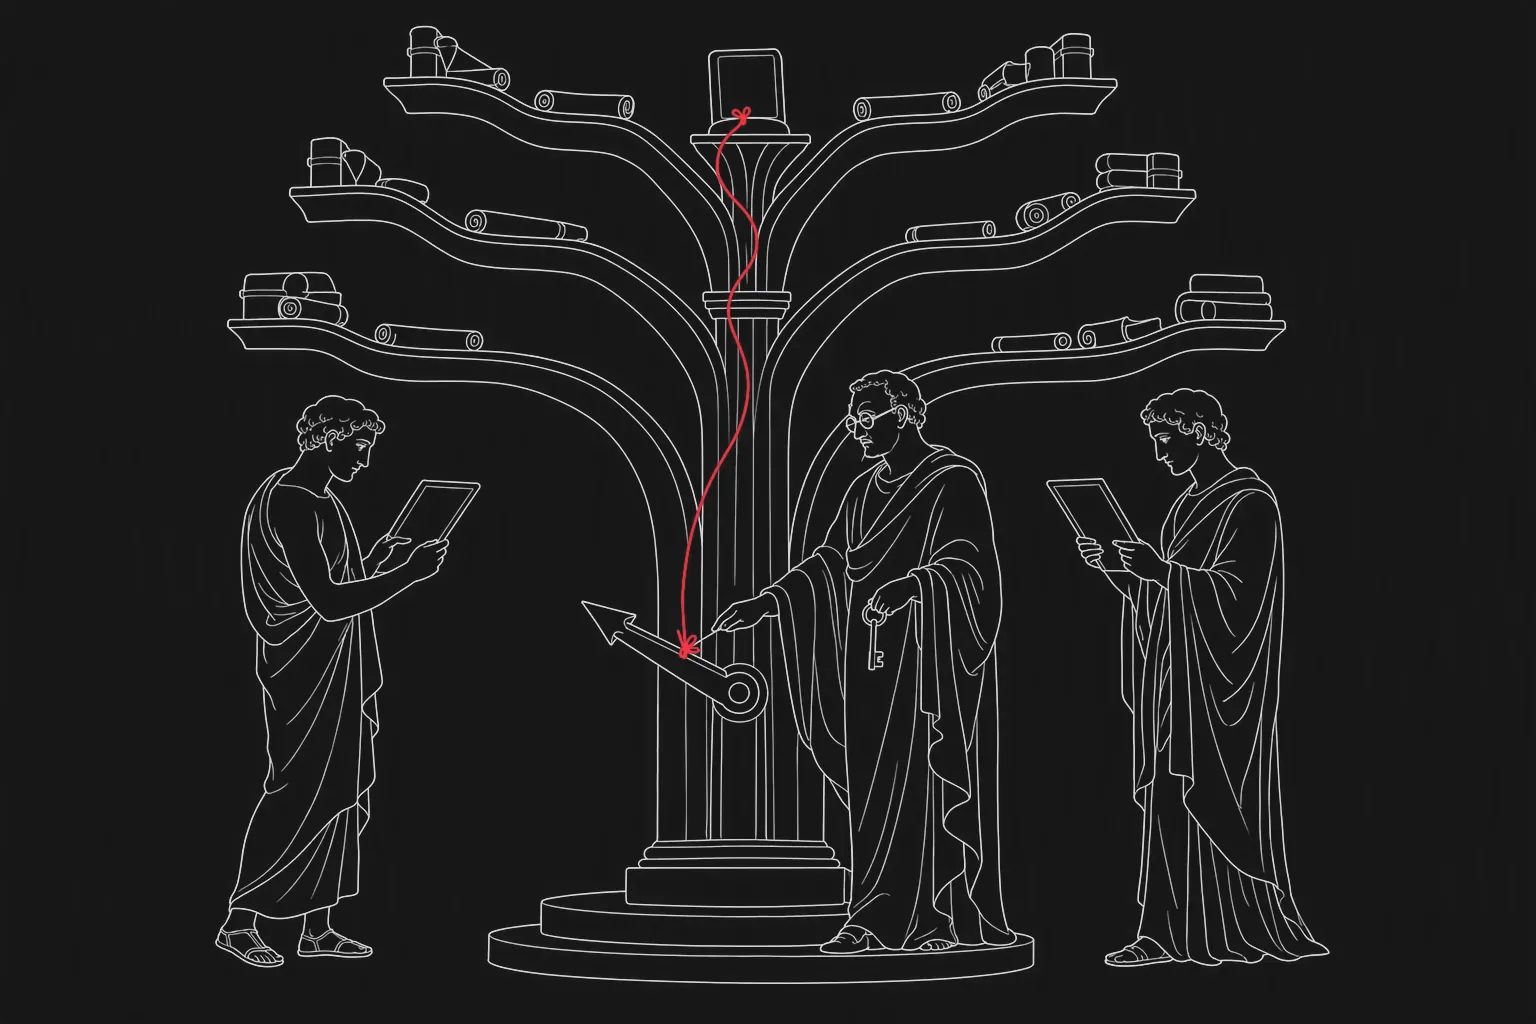
Tabela Iceberg to drzewo niezmiennych plików. Specyfikacja, sprawdzona 21.10.2026, rozkłada je tak: plik metadanych tabeli trzyma schemat, specyfikacje partycji i listę migawek; każda migawka wskazuje listę manifestów; lista manifestów wskazuje manifesty; każdy manifest, plik Avro, wylicza pliki danych i pliki usunięć ze statystykami kolumn. Zapytanie planuje się, schodząc po tym drzewie i przycinając po statystykach, zanim otworzy choć jeden plik Parquet.
Niczego w drzewie nigdy się nie modyfikuje. Commit zapisuje nowe manifesty, nową listę manifestów i nowy plik metadanych, a potem prosi katalog o przestawienie wskaźnika tabeli ze starego pliku metadanych na nowy — atomowo i tylko wtedy, gdy nikt inny nie przestawił go wcześniej. Ta jedna podmiana jest jedyną zmienną operacją. Dlatego kilka silników różnych vendorów może pisać do jednej tabeli bez koordynowania się między sobą: koordynują się z katalogiem.
Infografika
Drzewo metadanych Iceberg
- 01Wskaźnik w kataloguBieżący plik metadanych każdej tabeli. Jedyna rzecz zmieniana w miejscu i jedyne miejsce kontroli dostępu.
- 02Plik metadanych tabeliSchemat, specyfikacje partycji, porządki sortowania, lista migawek. Niezmienny; nowy przy każdym commicie.
- 03MigawkaJeden spójny stan tabeli w danym momencie. Podróż w czasie czyta starszą.
- 04Lista manifestówKtóre manifesty należą do tej migawki, z podsumowaniami partycji do przycinania.
- 05ManifestyPliki Avro wyliczające pliki danych i pliki usunięć ze statystykami kolumn.
- 06Pliki danych i usunięćDane w Parquet (albo ORC, Avro); pliki usunięć, a w v3 wektory usunięć w plikach Puffin.
Dla przedsiębiorstwa wynikają z tego dwie rzeczy. Po pierwsze, tabela nie należy do silnika: Spark może zapisać migawkę, którą Trino przeczyta sekundę później, a Snowflake może przeczytać tę samą migawkę ze swojej usługi. Po drugie, kto trzyma wskaźnik, ten trzyma tabelę. Pliki mogą leżeć w waszym kubełku w otwartym formacie, ale jeśli katalog jest usługą, której nie da się wyeksportować ani przestawić, plan wyjścia nie jest skończony.
Co jest w bieżącej specyfikacji
Wersja 3 specyfikacji jest przyjęta. Dodaje binarne wektory usunięć w plikach Puffin, pochodzenie wierszy, typ variant dla danych półstrukturalnych, typy geometry i geography, znaczniki czasu w nanosekundach, wartości domyślne kolumn i transformacje wieloargumentowe. Wersja 4 jest w pracach i nieprzyjęta. Wydanie biblioteki to Iceberg 1.12.0 z 30 września 2026, które wnosi zapis i odczyt variant do Spark, Flink i Kafka Connect oraz porzuca Spark 3.4 i Flink 2.0 (sprawdzono 21.10.2026). Silnik, który „obsługuje Iceberg”, może obsługiwać v2, a nie v3; wersja jest linią w dokumencie architektury, nie założeniem.
Dwie funkcje znaczą w użyciu enterprise więcej, niż sugerują ich nazwy.
Ukryte partycjonowanie. Tabela deklaruje, że jest partycjonowana po, powiedzmy, miesiącu daty
zamówienia, jako transformacji kolumny. Czytelnicy filtrują po kolumnie, a planer zamienia filtr na
przycinanie partycji; nikt nie pisze ręcznie WHERE month = '2026-09' ani nie myli się w tym. Agent
kodujący, który generuje zapytania do tabeli, nie musi znać układu partycji, co usuwa całą klasę
wolnego albo błędnego generowanego SQL.
Ewolucja partycji. Gdy partycje miesięczne stają się za grube, specyfikację zmienia się na dzienną dla nowych danych, z nowym identyfikatorem. Stare dane zostają, jak są; zapytania planują się po obu. Tabela nie jest przepisywana. W pięcioletnim środowisku to różnica między wnioskiem o zmianę a projektem migracji.
Katalogi: gdzie siedzi prawdziwa decyzja
Specyfikacja katalogu REST definiuje, jak klient wylicza przestrzenie nazw i tabele, zatwierdza, planuje skany i otrzymuje wydane poświadczenia do magazynu. Każdy katalog, który ją implementuje, wygląda tak samo dla Spark, Trino czy PyIceberg. Otwarte implementacje to Apache Polaris, projekt najwyższego poziomu Apache od 19 lutego 2026 z wydaniem 1.8.0 z 28 września 2026, oraz Lakekeeper; zarządzane to Snowflake Open Catalog (zarządzany Polaris), katalog lakehouse Google Cloud z punktem REST, AWS S3 Tables z wbudowanym Icebergiem i Databricks, który udostępnia zarządzane tabele Iceberg przez punkt REST w Unity Catalog (dokumentacja vendorów, sprawdzono 21.10.2026).
Wybór między nimi to wybór tego, kto może nadać dostęp do wskaźnika, kto może wyeksportować stan katalogu i jak wygląda wyjście. Środowisko z plikami Iceberg we własnym magazynie i katalogiem, który może prowadzić albo przestawić, ma plan wyjścia. Środowisko z plikami Iceberg i katalogiem, którego może tylko używać, ma połowę planu.
Przykład dydaktyczny: jedna tabela dla Trino i Snowflake
Weźmy grupę z pierwszego akapitu; to ilustracja projektu, nie opis klienta. Tabele klientów i zamówień powstają raz, w Icebergu, w magazynie obiektowym grupy. Katalog REST, który grupa prowadzi sama — Polaris albo Lakekeeper — trzyma wskaźniki. Trino czyta i pisze przez niego; Snowflake czyta te same tabele przez integrację katalogu; zadania Spark, które przygotowują cechy dla modelu odpływu klientów, czytają te same migawki.
Agent kodujący szkicuje potoki ze schematów źródłowych, szkicuje zadania kompaktowania i przepisywania manifestów ze wzorca zapisu, generuje instrukcję ewolucji partycji, gdy potrzebna jest granulacja dzienna, i pisze testy kontraktowe: te same liczby i sumy przez Trino i Snowflake, zmiana schematu wykonana ze Sparka i widoczna z obu, odczyt z podróżą w czasie do migawki, na której trenowano model. Każda rzecz idzie przez pull request z załączonymi wynikami.
Inżynier decyduje i zapisuje: który katalog i że da się go wyeksportować; kto ma które uprawnienie do której przestrzeni nazw; okno wygaszania migawek, bo wygaszanie migawek jest tym, co czyni usunięcie ostatecznym i zatrzymuje podróż w czasie; do której wersji specyfikacji środowisko się zobowiązuje, z czytelnikami, którzy ją ograniczają; i że ścieżka zapisu do tabeli zamówień należy tylko do jednego potoku. Agent modelu odpływu czyta lakehouse; proponowaną ofertę utrzymania klienta zapisuje do CRM przez interfejs CRM, gdzie potwierdza ją człowiek.
Jak do tego podchodzimy
Pierwsza tabela decyduje o środowisku. Budujemy ją w Icebergu z katalogiem, który możecie prowadzić albo przestawić, czytamy z każdego silnika, który będzie jej potrzebował, piszemy z tych, które muszą, i zostawiamy testy kontraktowe chodzące w potoku. Zadania kompaktowania, wygaszania migawek i manifestów są zaplanowane i wycenione, zanim powstanie druga tabela. Agenci kodujący szkicują pracę; wasz architekt jest właścicielem katalogu, uprawnień, retencji i wersji specyfikacji, z każdą rzeczą zapisaną.
Nasza część
W inżynierii danych AI budujemy warstwę Iceberg, na której można oprzeć plan wyjścia: tabele w waszym magazynie, katalog pod waszą kontrolą, silniki, które macie, czytające i piszące, oraz zadania serwisowe z właścicielem. Nie odsprzedajemy platform ani katalogów. Więcej o predictes na stronie głównej.
- Apache Iceberg
- katalog REST
- plan wyjścia
- wiele chmur